数据库
数据库按存储模型和查询方式分类。下面列出各类的用途、使用场景和常见系统。PostgreSQL、InfluxDB 写到对象模型和查询语句,其余系统写到模型和负载。
消息队列保存待消费的事件,注册与配置中心保存会被监听的配置和注册信息。二者的数据模型与数据库不同,但与数据库处在同一套业务系统中。JDBC(Java Database Connectivity,Java 数据库连接)和 MySQL、PostgreSQL 协议兼容是接入方式,达梦、Snowflake、Hive 等多采用这种方式。接入之后,系统仍归入下面某一类。
1. 分类
| 类别 | 用途 | 使用场景 | 代表系统 |
|---|---|---|---|
| 关系型 | 以事务保存结构化记录,并支持表间关联 | 账户、订单、库存、权限 | PostgreSQL、MySQL、Oracle、SQL Server、SQLite |
| 分析型 | 对大批量数据做扫描和聚合 | 报表、多维统计、明细分析 | ClickHouse、Doris、Snowflake、BigQuery |
| 文档、键值与搜索 | 按文档、键、行键或倒排索引访问 | 内容、缓存、全文检索、宽表归档 | MongoDB、Redis、Elasticsearch、Cassandra |
| 图与向量 | 遍历节点和边,或按向量距离检索 | 关系网络、语义检索、相似推荐 | Neo4j、Milvus、Qdrant |
| 时序 | 按时间追加数据点,并做时间窗口聚合 | 监控指标、接口耗时、设备采样 | InfluxDB、TDengine、Prometheus |
| 消息队列 | 暂存事件,由其他系统按位移或队列消费 | 异步通知、日志采集、库表变更同步 | Kafka、RabbitMQ、RocketMQ |
| 注册与配置 | 保存配置、服务实例和主节点,并通知变更 | 服务发现、配置下发、集群选主 | etcd、Nacos、ZooKeeper |
2. 关系型数据库
数据组织为表。列有类型,行是一条记录,表之间通过主键和外键关联。查询语言为 SQL。多条写入可置于同一事务:提交后同时可见,失败则回滚。此类负载称为 OLTP(Online Transaction Processing,联机事务处理)。
| 系统 | 端口 | 说明 |
|---|---|---|
| Oracle | 1521 | 商业系统,过程语言为 PL/SQL |
| SQL Server | 1433 | 使用 T-SQL,常见于 Windows 与 .NET 环境 |
| MySQL | 3306 | 默认事务引擎为 InnoDB。MariaDB 为其分支。TiDB、OceanBase 使用 MySQL 协议提供分布式能力 |
| SQLite | 无独立服务端口 | 数据库为单个文件,由进程内库访问 |
| 达梦 | 视部署而定 | 语法和运维对象接近 Oracle |
| openGauss、GaussDB | 视部署而定 | 基于 PostgreSQL。协议兼容不包含系统目录和管理命令 |
PostgreSQL
默认端口 5432。PostGIS、pgvector、TimescaleDB 分别以扩展提供地理数据、向量和时序。
| 对象 | 作用 |
|---|---|
| database | 独立数据空间,由连接参数指定 |
| schema | 命名空间,默认名为 public |
| table / view | 表存储行,视图保存一条查询 |
| role | 登录身份与权限主体 |
timestamptz 存储绝对时刻。timestamp 不包含时区。参与约束和关联的属性使用独立列;结构不稳定的附属信息使用 jsonb,索引类型为 GIN。等值、范围和排序使用 B-tree。
并发控制为 MVCC(Multi-Version Concurrency Control,多版本并发控制):更新生成新行版本,读不阻塞写。未结束的长事务会保留旧版本。查询账号通常只授予 SELECT。
1 | SELECT id, status, created_at |
3. 分析型数据库
分析型系统针对大批量扫描和聚合,负载称为 OLAP(Online Analytical Processing,联机分析处理)。数据从关系库、日志或消息队列同步而来。查询延迟通常在秒级或更长,单次查询处理的行数远高于 OLTP。
| 系统 | 模型 |
|---|---|
| ClickHouse | 列式存储。同一列连续存放,用于事件明细的过滤和聚合,如日志、点击、账单 |
| Doris、StarRocks | 实时分析引擎,查询协议为 MySQL |
| Snowflake、BigQuery | 云数据仓库。存储与计算分离,按计算资源计费,用于跨业务表的汇总 |
| Databricks | 数据存放在数据湖文件中,常见格式为 Delta Lake,查询层为 Spark SQL |
| Trino | 分布式 SQL 引擎。存储位于 Hive、Iceberg、PostgreSQL 等外部系统,Trino 负责查询 |
订单的当前状态保留在关系库。按地区、渠道统计一段时间的支付金额时,读取同步到分析库的明细。同步存在秒级到分钟级延迟。
4. 文档、键值与搜索
这一类包含四种模型:文档、键值、宽表、倒排索引。访问路径不同。
4.1 文档数据库
一条记录是一篇文档,编码多为 JSON 或 BSON。同一集合中的文档字段可以不同。
MongoDB 的默认端口为 27017,查询使用其查询语言和聚合管道,用于内容、活动配置和字段经常变化的档案。CouchDB 通过 HTTP 访问文档,支持多主复制,用于需要离线同步的数据。
金额、库存等需要约束和对账的字段放在关系库。
4.2 键值数据库
按键读取对应的值。Redis 的默认端口为 6379,值类型包括字符串、哈希、列表、集合和有序集合。数据主要驻留内存,用于缓存、会话、计数和分布式锁。RDB 与 AOF 将内存数据写入磁盘。Redis 模块可以在同一进程中提供搜索或向量索引。
4.3 宽表与列族
行键决定数据所在分片,列按列族分组,单行的列数可以很大。
Cassandra 无独立主节点,写入路径短,用于跨数据中心的高写入。查询条件需要包含分区键。HBase 运行于 Hadoop 文件系统之上,按行键和列族组织,用于历史归档和画像等稀疏宽表。
4.4 搜索引擎
Elasticsearch 的常见端口为 9200。文本切分为词项后建立倒排索引,再与过滤、聚合组合,用于全文检索和日志检索。OpenSearch 与其同源。Meilisearch 的索引规模和功能面更小,用于站内搜索。
正文和业务状态存放在主库。搜索引擎保存由主库同步出来的索引。
5. 图数据库与向量数据库
关系用边表示、或用高维向量表示时,使用图数据库或向量数据库。
5.1 图数据库
图由节点和边组成,边具有类型和属性。查询沿边进行有限步遍历。
Neo4j 实现属性图,查询语言为 Cypher,用于人物关系、资金网络和组件依赖。节点上的主数据通常另存一份在关系库。
5.2 向量数据库
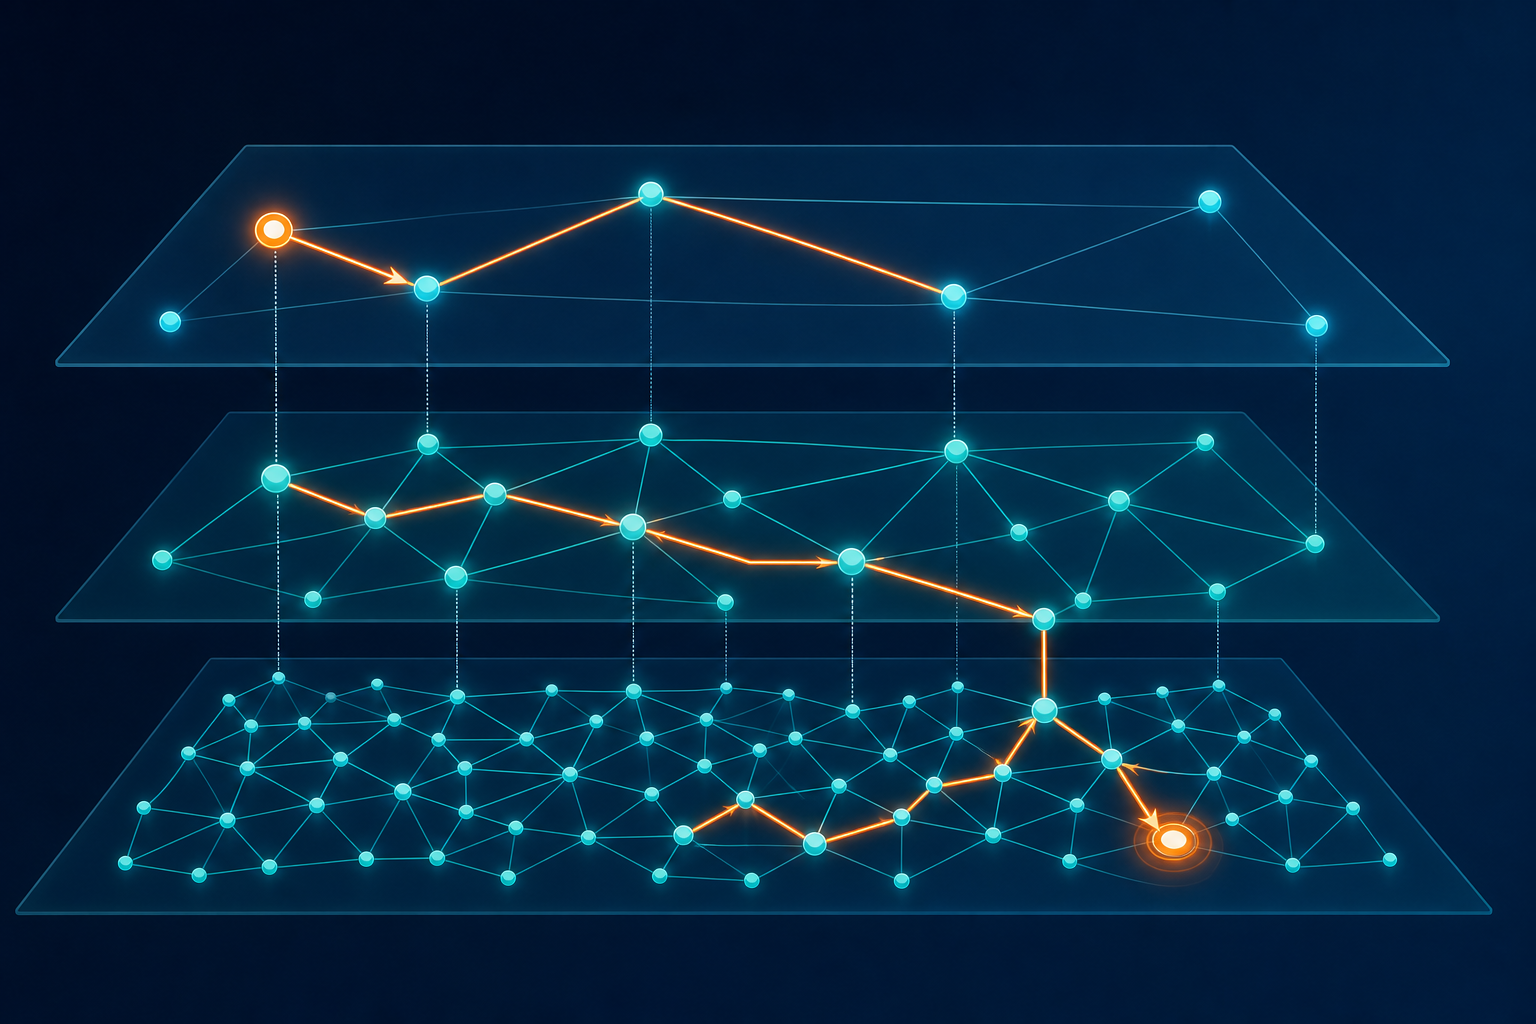
向量数据库存储嵌入(embedding),即文本、图像或音频对应的高维浮点数组。查询计算余弦距离、点积或欧氏距离,返回距离最近的若干条。数据规模大时使用近似最近邻索引。
| 系统 | 说明 |
|---|---|
| Milvus | 支持稠密向量、稀疏向量和混合检索,用于检索增强生成(RAG)和推荐 |
| Qdrant | 向量检索与标量过滤在同一次查询中执行 |
| Weaviate | 提供向量化模块,向量生成与检索处于同一系统 |
| ChromaDB | 可嵌入应用进程,用于小规模向量集合 |
| pgvector | PostgreSQL 扩展,向量与业务表位于同一实例 |
稠密检索比较语义向量,稀疏检索比较关键词权重,混合检索合并两类得分。评价指标包括召回率(前 K 个结果中的相关比例)和 QPS(每秒查询数)。
6. 时序数据库
一条时序数据包含时间戳、用于过滤的维度和数值字段。写入以追加为主。查询带有时间范围,并对窗口做聚合。原始点按保留策略删除或降采样。
| 系统 | 说明 |
|---|---|
| InfluxDB | 通用时序库,写入协议为 Line Protocol(行协议) |
| TDengine | 面向设备数据,以超级表描述同一类设备,查询语言接近 SQL |
| IoTDB | Apache 项目,按设备测点组织,面向工业高写入 |
| QuestDB | 使用 SQL 查询,同时接收 Influx 行协议 |
| TimescaleDB | PostgreSQL 扩展,时序数据与关系数据位于同一实例 |
| Prometheus | 监控系统内置的时序库,主动拉取指标,查询语言为 PromQL。与 Grafana 的关系见《Grafana生态》 |
InfluxDB
默认端口 8086。行协议由度量、标签、字段和时间戳组成:
1 | api_request,app=checkout,path=/pay latency_ms=42,status_code=200 1730000000000000000 |
| 部分 | 含义 |
|---|---|
| measurement | 度量名,对应一组点,上例为 api_request |
| tag | 已建索引的维度,上例为 app、path |
| field | 数值或状态,默认不建索引,上例为 latency_ms、status_code |
| timestamp | 该点的时间,行协议中单位通常为纳秒 |
标签的取值集合需要有限,例如应用、接口、机房。用户 ID、订单号、trace ID 的基数高,写入标签会导致索引膨胀。这类标识放在 PostgreSQL,时序库保留可聚合的数值。
1.x、2.x、3.x 的对象模型和查询语言不同:
| 版本 | 数据组织 | 认证 | 查询语言 |
|---|---|---|---|
| 1.x | database 与 retention policy(保留策略) | 用户名、密码 | InfluxQL |
| 2.x | organization 与 bucket(桶) | API token | Flux;部分接口接受 InfluxQL |
| 3.x | 表;写入仍可使用行协议 | token | SQL、InfluxQL |
1.x 查询最近一小时的平均耗时:
1 | SELECT mean(latency_ms) |
2.x 的对应 Flux 为:
1 | from(bucket: "metrics") |
原始序列按保留时间删除。分钟或小时聚合另存一条序列,供看板和告警读取。订单状态在 PostgreSQL,接口延迟在 InfluxDB。
7. 消息队列
消息队列保存已经产生、尚未被消费的事件,提供堆积和按位置重放。事务型主数据仍在关系库。消费进度与库中的业务状态是两套数据。
| 系统 | 模型 | 场景 |
|---|---|---|
| Kafka | 主题上的追加日志,消费者自行记录位移 | 日志采集、事件流、向分析库同步变更 |
| RabbitMQ | 交换机按路由键将消息写入队列 | 任务分发 |
| RocketMQ | 主题、队列与消费组,支持事务消息 | 订单、支付链路中的异步处理 |
| Pulsar | 服务层与存储层分离,主题隶属于租户和命名空间 | 多租户消息 |
8. 注册与配置中心
存放配置项、主节点和服务实例。数据量小,要求一致的读写和变更通知。业务记录在关系库,此处存放进程运行所读取的配置。
| 系统 | 用途 |
|---|---|
| etcd | 带租约和监听的键值存储。Kubernetes 用它保存集群状态 |
| ZooKeeper | 以 ZNode 做协调。Hadoop 及早期 Kafka 用它选主和保存元数据 |
| Nacos | 配置管理与服务注册,用于微服务 |
| Consul | 服务发现与 KV,同时提供健康检查 |
9. DBX
同时连接上述多类系统时,可以使用 DBX。它是开源数据库客户端,源码位于 t8y2/dbx。SQL 系统使用查询编辑器、结果网格和表结构;文档、键值、搜索、向量、时序、消息队列和配置中心使用对应的对象界面。桌面版在本机运行。Docker / Web 版在服务器运行,通过浏览器访问。命令行和 MCP(Model Context Protocol,模型上下文协议)读取同一份连接配置,供脚本和外部程序调用。
命令行对 PostgreSQL 可直接查询。InfluxDB 需要桌面版处于运行状态,命令行经桥接访问,以 dbx capabilities 的输出为准。连接可设置为只读,或在检测到写操作时要求确认。权限由数据库账号决定。其导出功能用于小库迁移;生产数据的备份使用数据库自身的备份工具。